Google、OpenAI、Microsoftは2026年10月30日、WebサイトのコンテンツをAIの学習に使ってよいかを、サイト運営者が共通の書き方で示せる仕組みに対応すると発表しました。Anthropicも実装に着手しています。対応は2027年から順次始まります。
ニュースサマリー
AI学習の共通仕様とは?何が発表されたか
これまでサイト運営者は、AIの学習への利用を断るために、AI企業ごとに異なるクローラー名や設定方法に対応する必要がありました。今回の仕組みは、インターネット技術の標準化団体IETFで検討中の仕様に基づき、Anthropicの技術者が10月30日に具体的な書き方を提案したものです。
主な内容
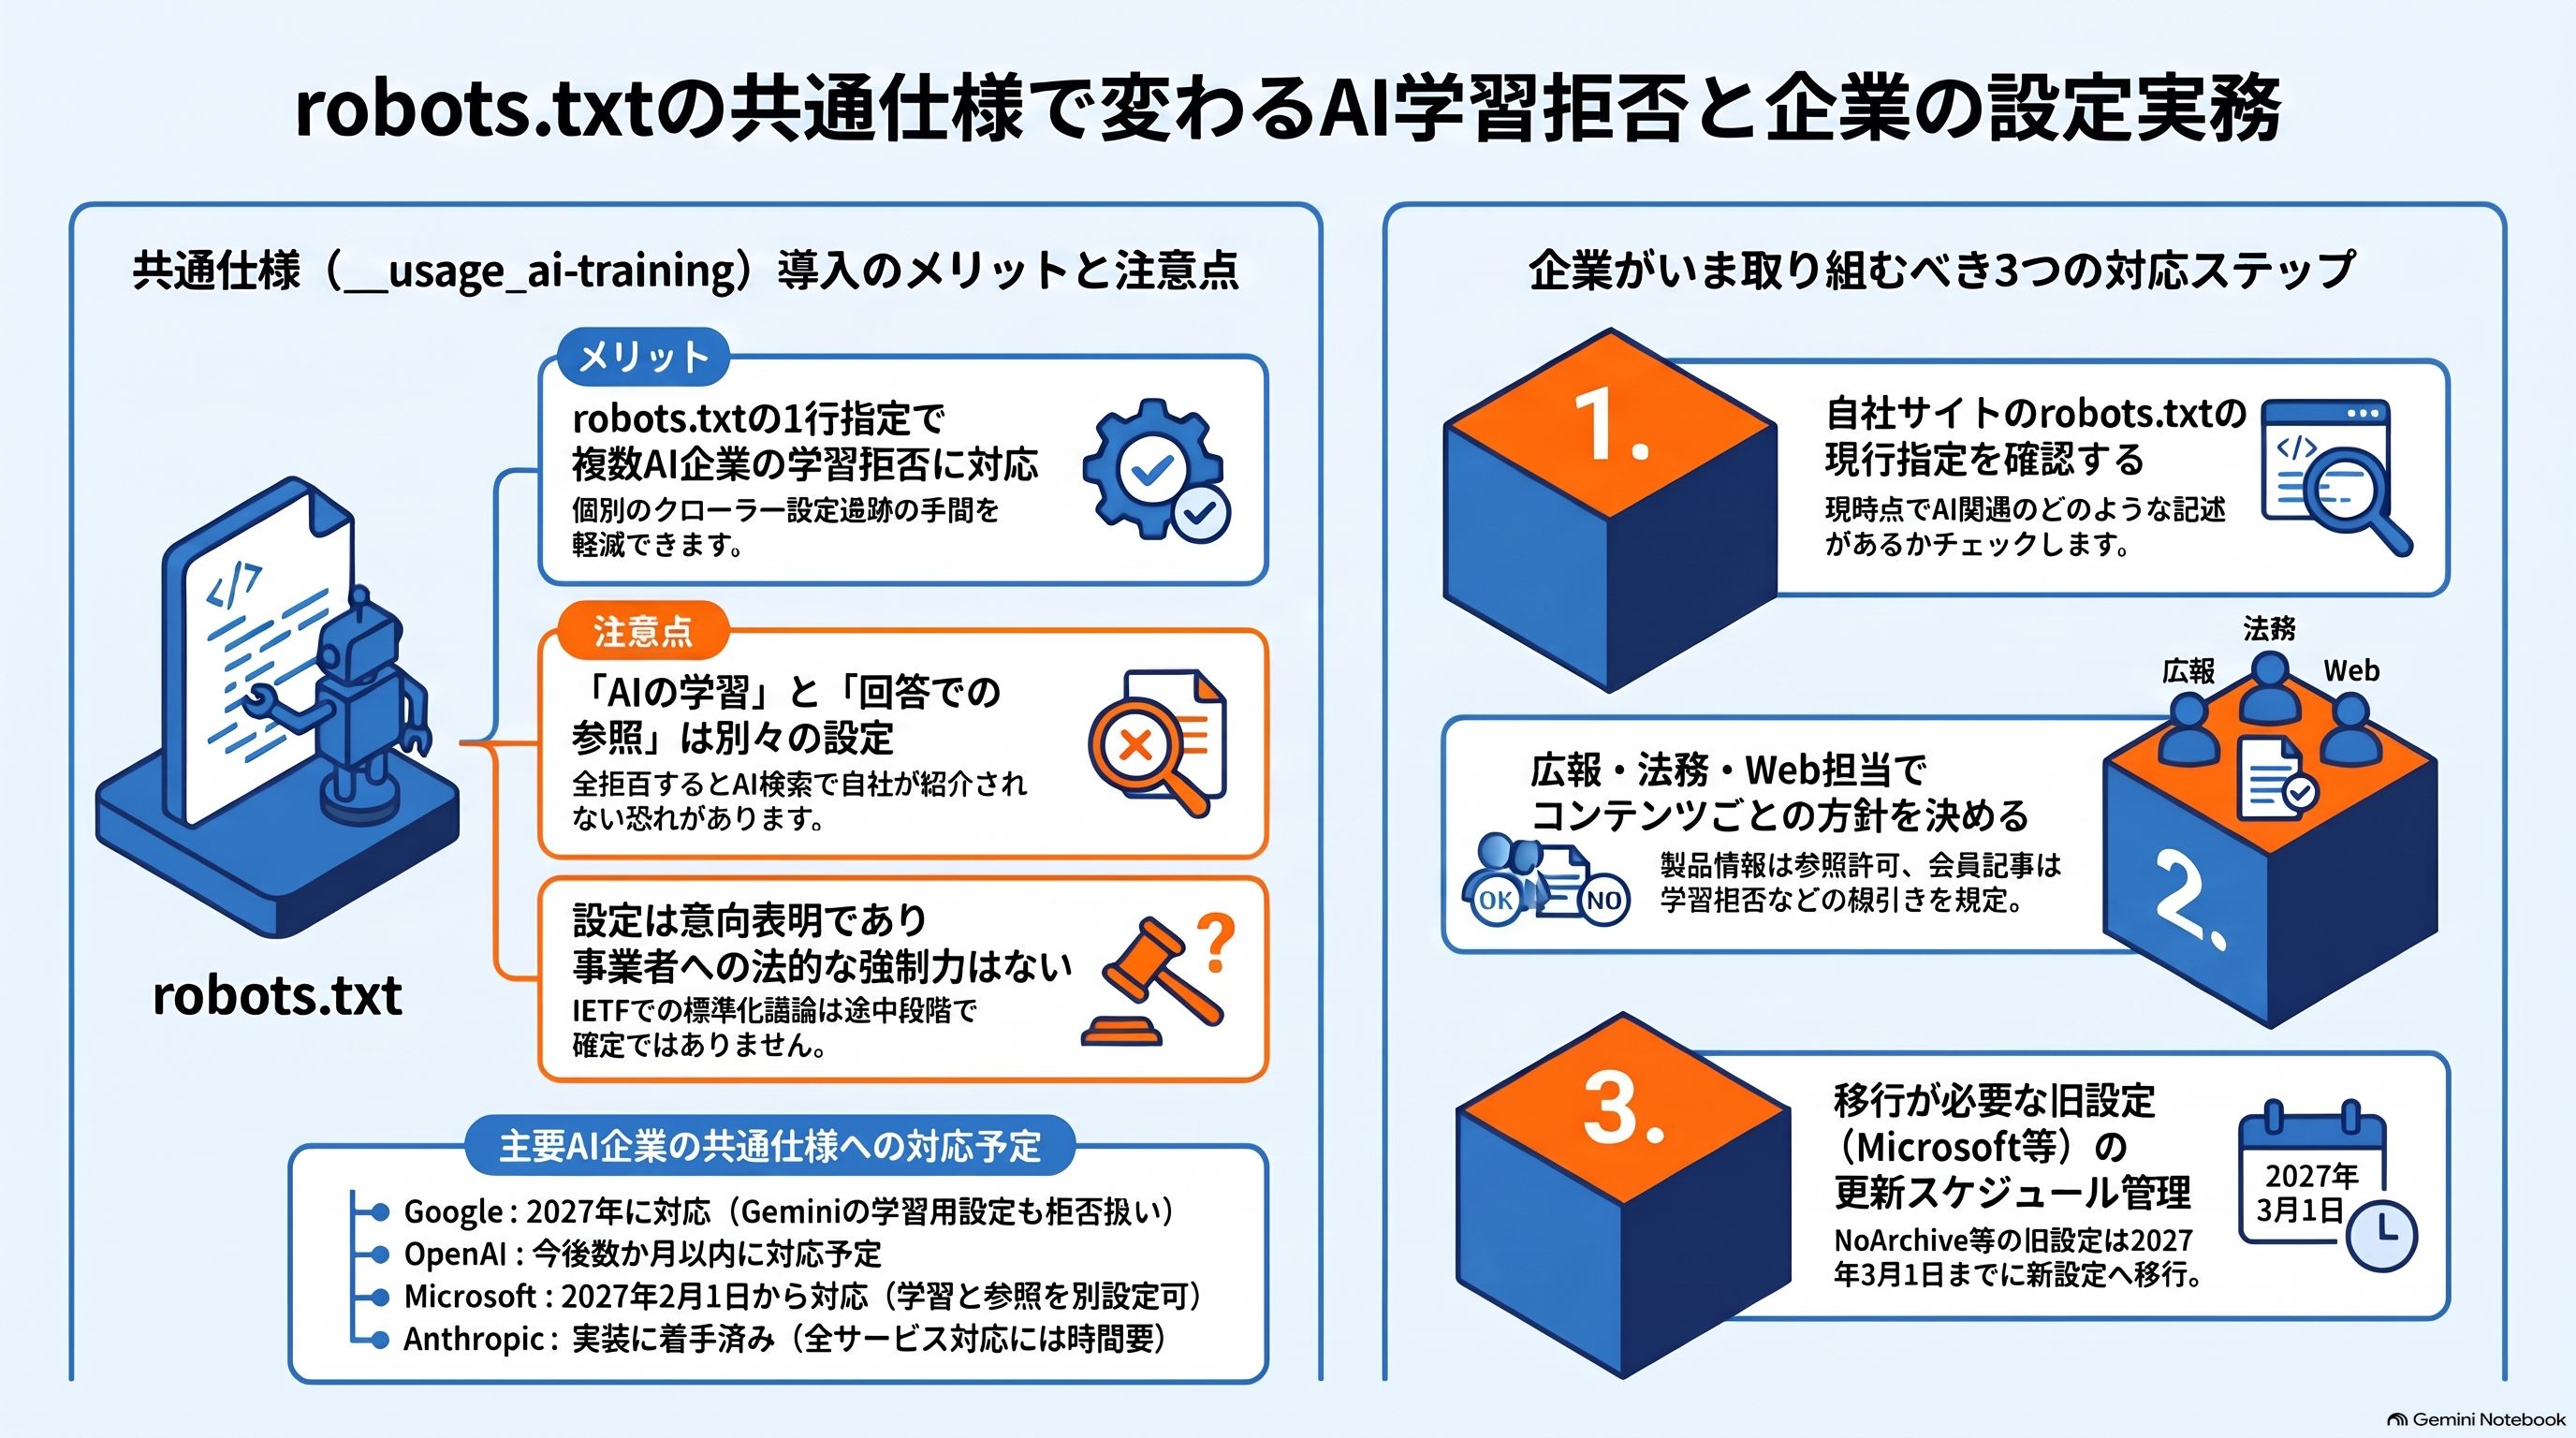
robots.txtに「__usage_ai-training」という共通の名前で指定すれば、対応する複数のAI企業へ意向を一度に示せます。
サイト全体を拒否するだけでなく、特定のフォルダだけを許可するといった指定もできます。
この設定はAIの学習に使うかどうかの意向を示すもので、サイトへのアクセス自体は止めません。
IETFでの標準化は途中の段階で、正式な標準としてはまだ確定していません。
各社の対応時期
Google:2027年に対応。共通仕様で拒否すればGeminiの学習用の設定も拒否として扱う
OpenAI:今後数か月以内に対応
Microsoft:2027年2月1日から。学習と、回答を作る際の参照を別々に設定可能に
Anthropic:実装に着手済み。全サービスへの対応には時間がかかる見通し
運営からのコメント
なぜ今、このニュースが重要なのか
自社サイトの製品情報や記事がAIの学習に使われるかどうかは、広報や法務の担当者にとって見過ごせない問題になっています。ところが、AI企業ごとにクローラーの名前や設定方法が異なり、新しいAIサービスが出るたびに設定を追いかける必要がありました。主要な4社が同じ書き方に足並みをそろえたことで、サイト運営者が設定を管理する手間は大きく減ります。AIと自社コンテンツの関係を、企業が自ら選びやすくなる一歩です。
最大のポイント
見落とされやすいのは、「学習に使われること」と「AIの回答で参照されること」が別物だという点です。今回の共通仕様が扱うのは学習だけで、AIが回答を作る際に自社サイトを参照するかどうかは別の設定になります。何も考えずにすべてを断ると、AIによる検索で自社が紹介されにくくなるおそれもあります。また、この設定はあくまで意向の表明で、従わない事業者に強制する力はありません。標準化の議論にも、まだ意見の分かれる点が残っています。
企業がいま取り組むべきこと
まず、自社サイトのrobots.txtに、AI関連のどんな指定が入っているかを確認してみてください。そのうえで、広報、法務、Web担当者が集まり、コンテンツの種類ごとに方針を決めます。たとえば、製品や会社の情報はAIの回答で参照されたい、会員向けの記事や独自のノウハウは学習に使われたくない、といった線引きです。MicrosoftのNoArchiveやNoCacheの設定を使っている場合は、2027年3月1日までに新しい設定へ移る必要があります。
出典
小松怜
Advanced AI Partnersのコンサルタント。 生成AIニュースの執筆を担当し、国内外の生成AIの最新動向を企業の実務目線で解説しています。