■通勤・移動中や朝の準備の際に動画の音声だけでも軽く聞いてみてください!
ニュースサマリー
概要
米グーグルは9月23日、テキストから音声を生成する新モデル「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表し、同日から提供を開始しました。選択できる声の種類が従来の30種類から2,000種類以上に大幅に拡大したほか、自然言語の指示でオリジナルの声を作り出せる機能や声の複製機能が追加されました。
具体的な取り組み・内容
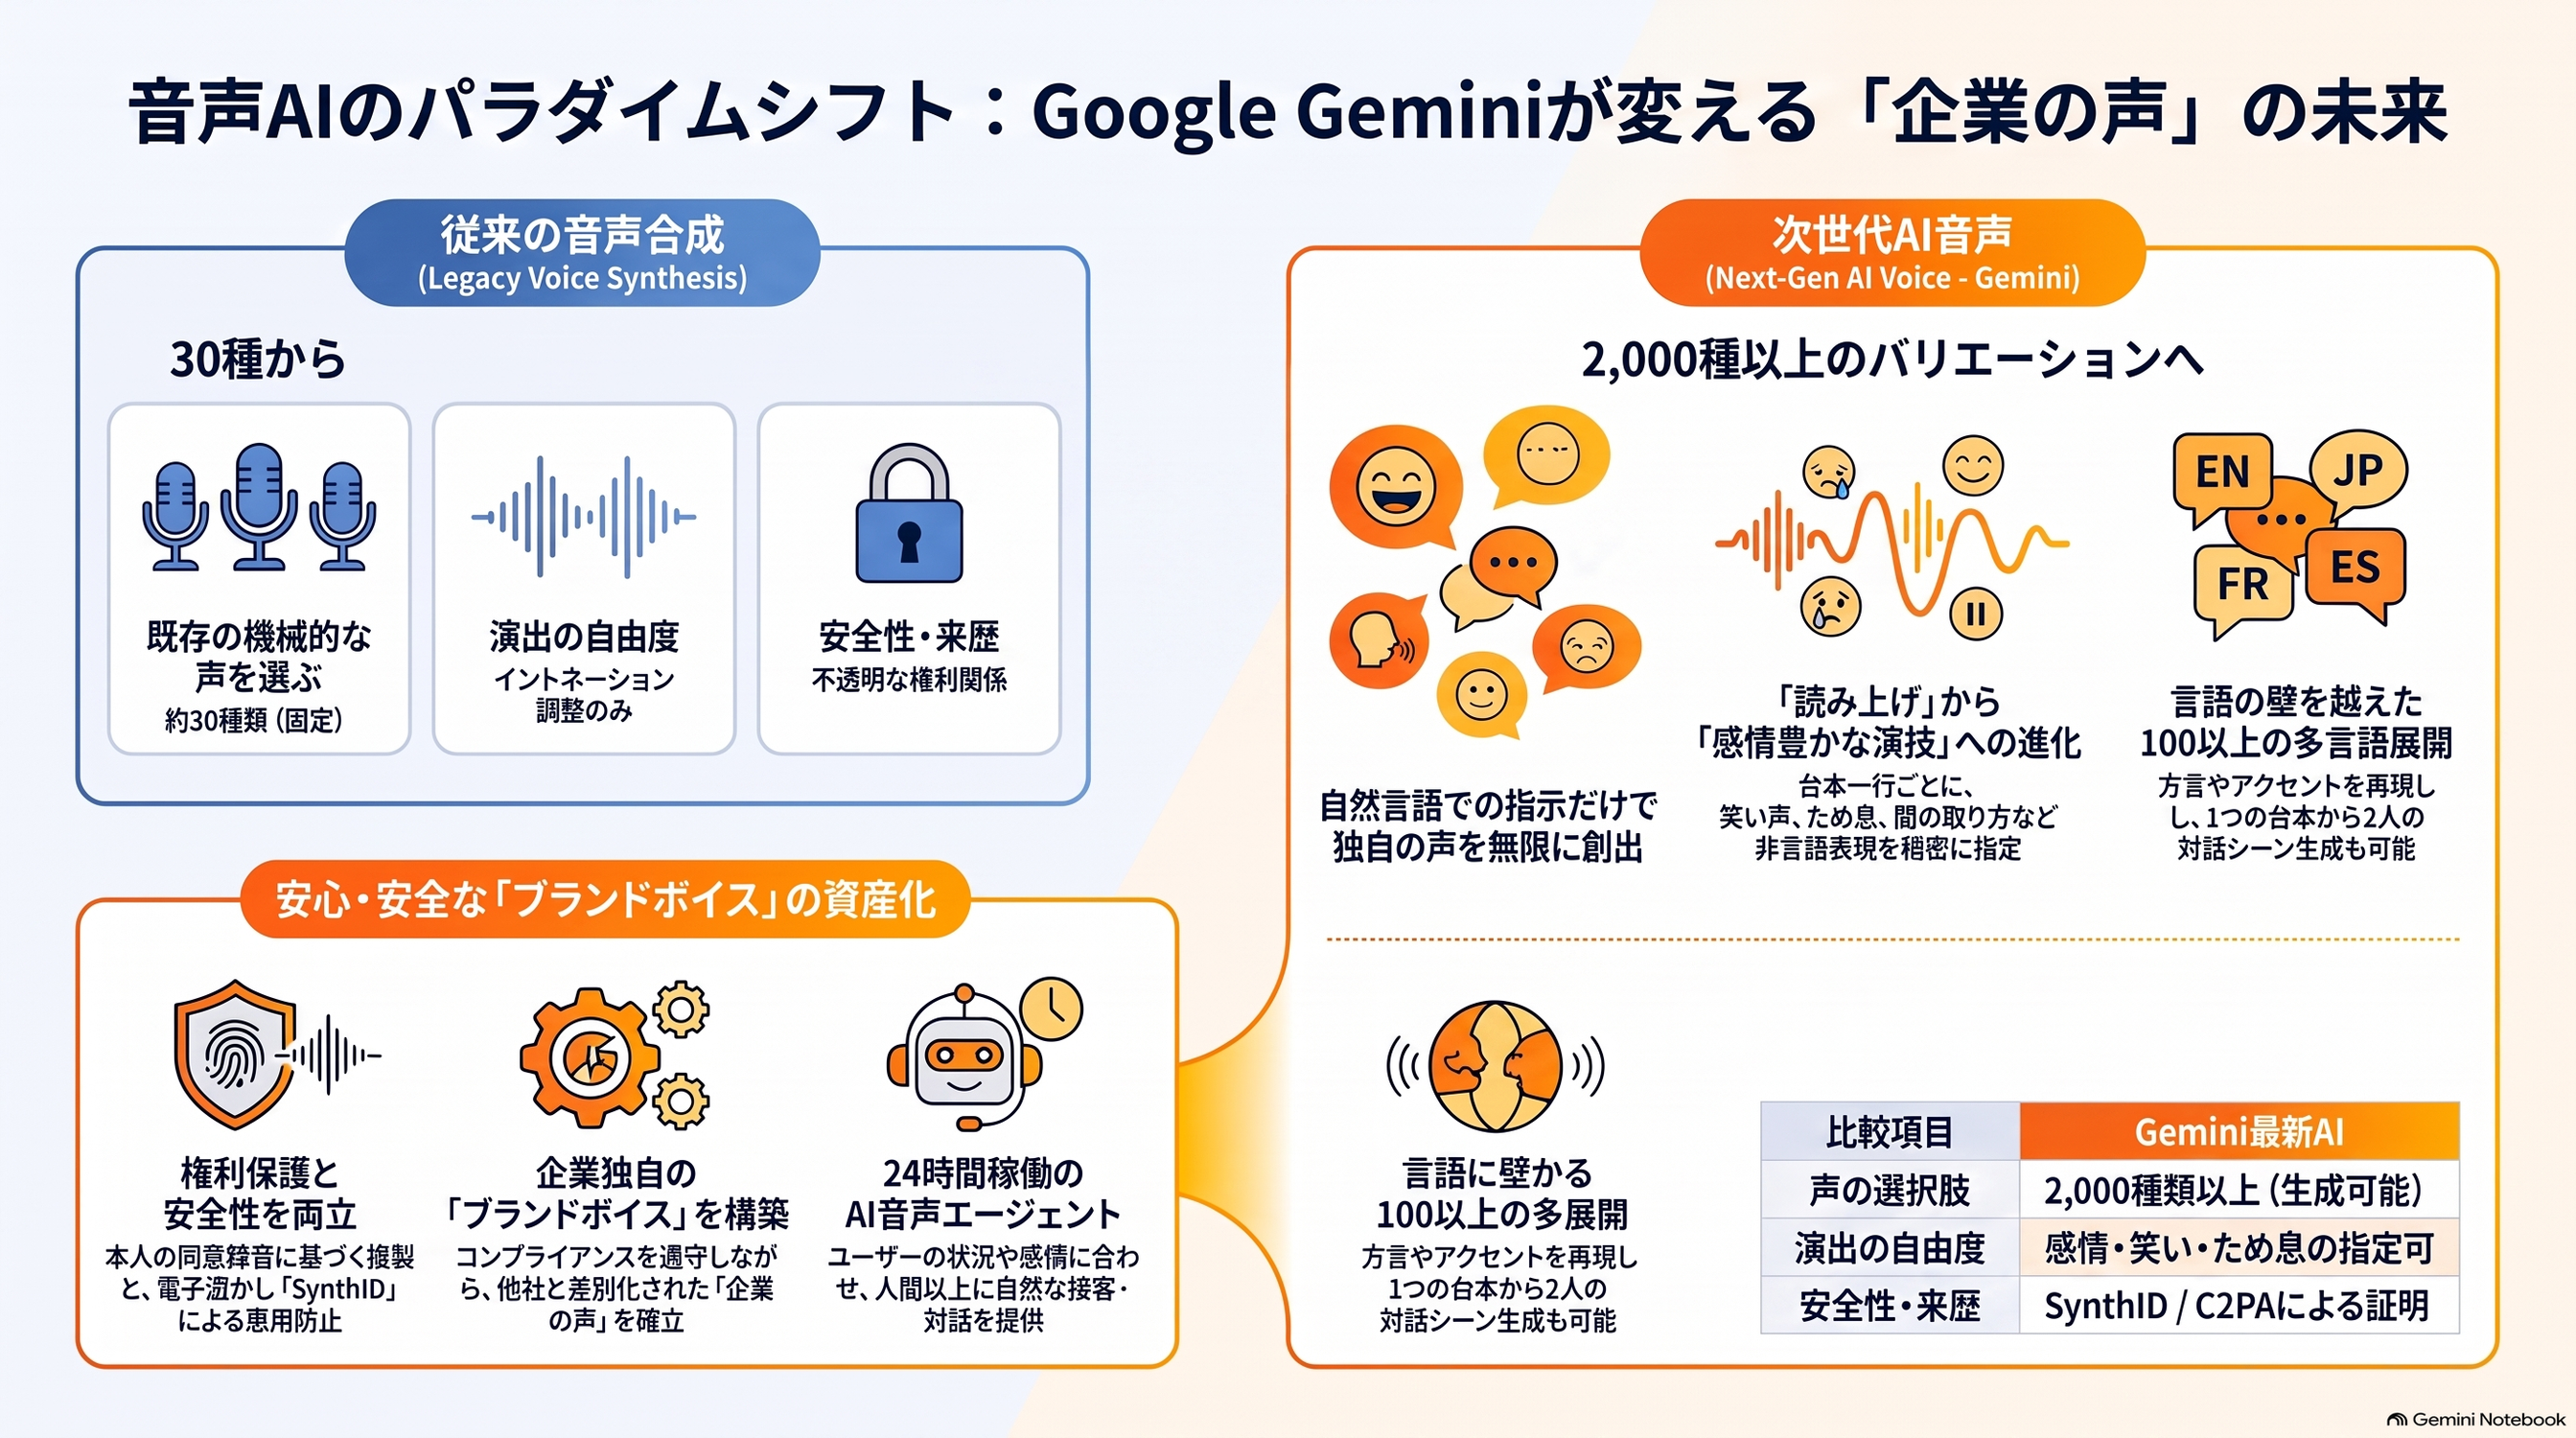
- 自然言語(文章)で役柄、なまり、声質を指示するだけで新たな声を自動生成可能。
- 30秒のサンプル音声と本人の同意録音から声質を再現する音声複製(ボイスレプリケーション)機能の実装。
- 台本の1行ごとに感情、間の取り方、笑い声やため息などの非言語表現、相づちを細かく指定可能。
- 100を超える言語と地域の方言・アクセントを再現し、2人の対話シーンも1つの台本から生成可能。
- 悪用防止策として電子透かし「SynthID」や「C2PA」の来歴情報を生成音声に埋め込み。
報告されている成果
- 音声デザインのベンチマーク(Hume AI)において総合評価およびなまりの再現で首位を獲得。
- 選択可能な声の種類が従来の30種類から2,000種類以上に増加。
- ブラインド評価(Voice Arena)において、日本語やブラジル系ポルトガル語など複数言語で上位評価を獲得。
運営からのコメント
なぜ今、このニュースが重要なのか?
従来のテキスト読み上げ技術は「あらかじめ用意された機械的な声を選ぶだけ」にとどまり、自社ブランドのイメージに合った声の確保や、多言語展開における莫大なコストが大きな課題でした。今回のGoogleの発表は、音声生成が単なる「読み上げ」から「感情豊かな演技やブランドボイスの自由な設計」へと次元を変えたことを示しています。コンテンツ制作や顧客対応の現場で「声のボトルネック」を感じていた企業にとって、今すぐ検証すべきパラダイムシフトと言えます。
最大のポイント
成功の本質は「声のバリエーション増加」ではなく、「声のキャラクター設計」と「セリフごとの演出」が完全にコントロール可能になった点にあります。さらに注目すべきは、厳格な権利保護の仕組み(本人の同意録音や透かし技術)が組み込まれていることです。コンプライアンスリスクを回避しながら、自社独自の「企業の声(ブランドボイス)」を安心・安全に構築・資産化できる体制が整ったことこそが、他社との圧倒的な差を生む決定的な要因となります。
我々が目指すべき「未来の業務の姿」
私たちが目指すべきは、単に「ナレーション原稿をAIに読ませる」というタスク効率化ではありません。あらゆるマニュアルや記事、FAQデータが、ユーザー一人ひとりの好みや状況に合わせた「感情豊かなAI音声エージェント」として即座に動画・音声化される世界です。対話の文脈やユーザーの感情を汲み取り、人間以上に自然で説得力のあるコミュニケーションを24時間自動で提供する——そんな新たな顧客体験と価値創造の未来が、すぐ目の前まで来ています。
小松怜
Advanced AI Partnersのコンサルタント。生成AIニュースの執筆を担当し、国内外の生成AIの最新動向を企業の実務目線で解説しています。
別の記事もご覧ください
AAIP Journal トップへ