米Cloudflareは2026年10月1日、データ分析基盤「Cloudflare Basin」の一般提供を始めました。データの取り込み・保管・SQL分析をサーバー管理なしで行え、外部への転送料もかかりません。AIが使う社内データを、特定ベンダーに縛られずに置ける選択肢が増えます。
ニュースサマリー
Cloudflare Basinとは?何が発表されたか
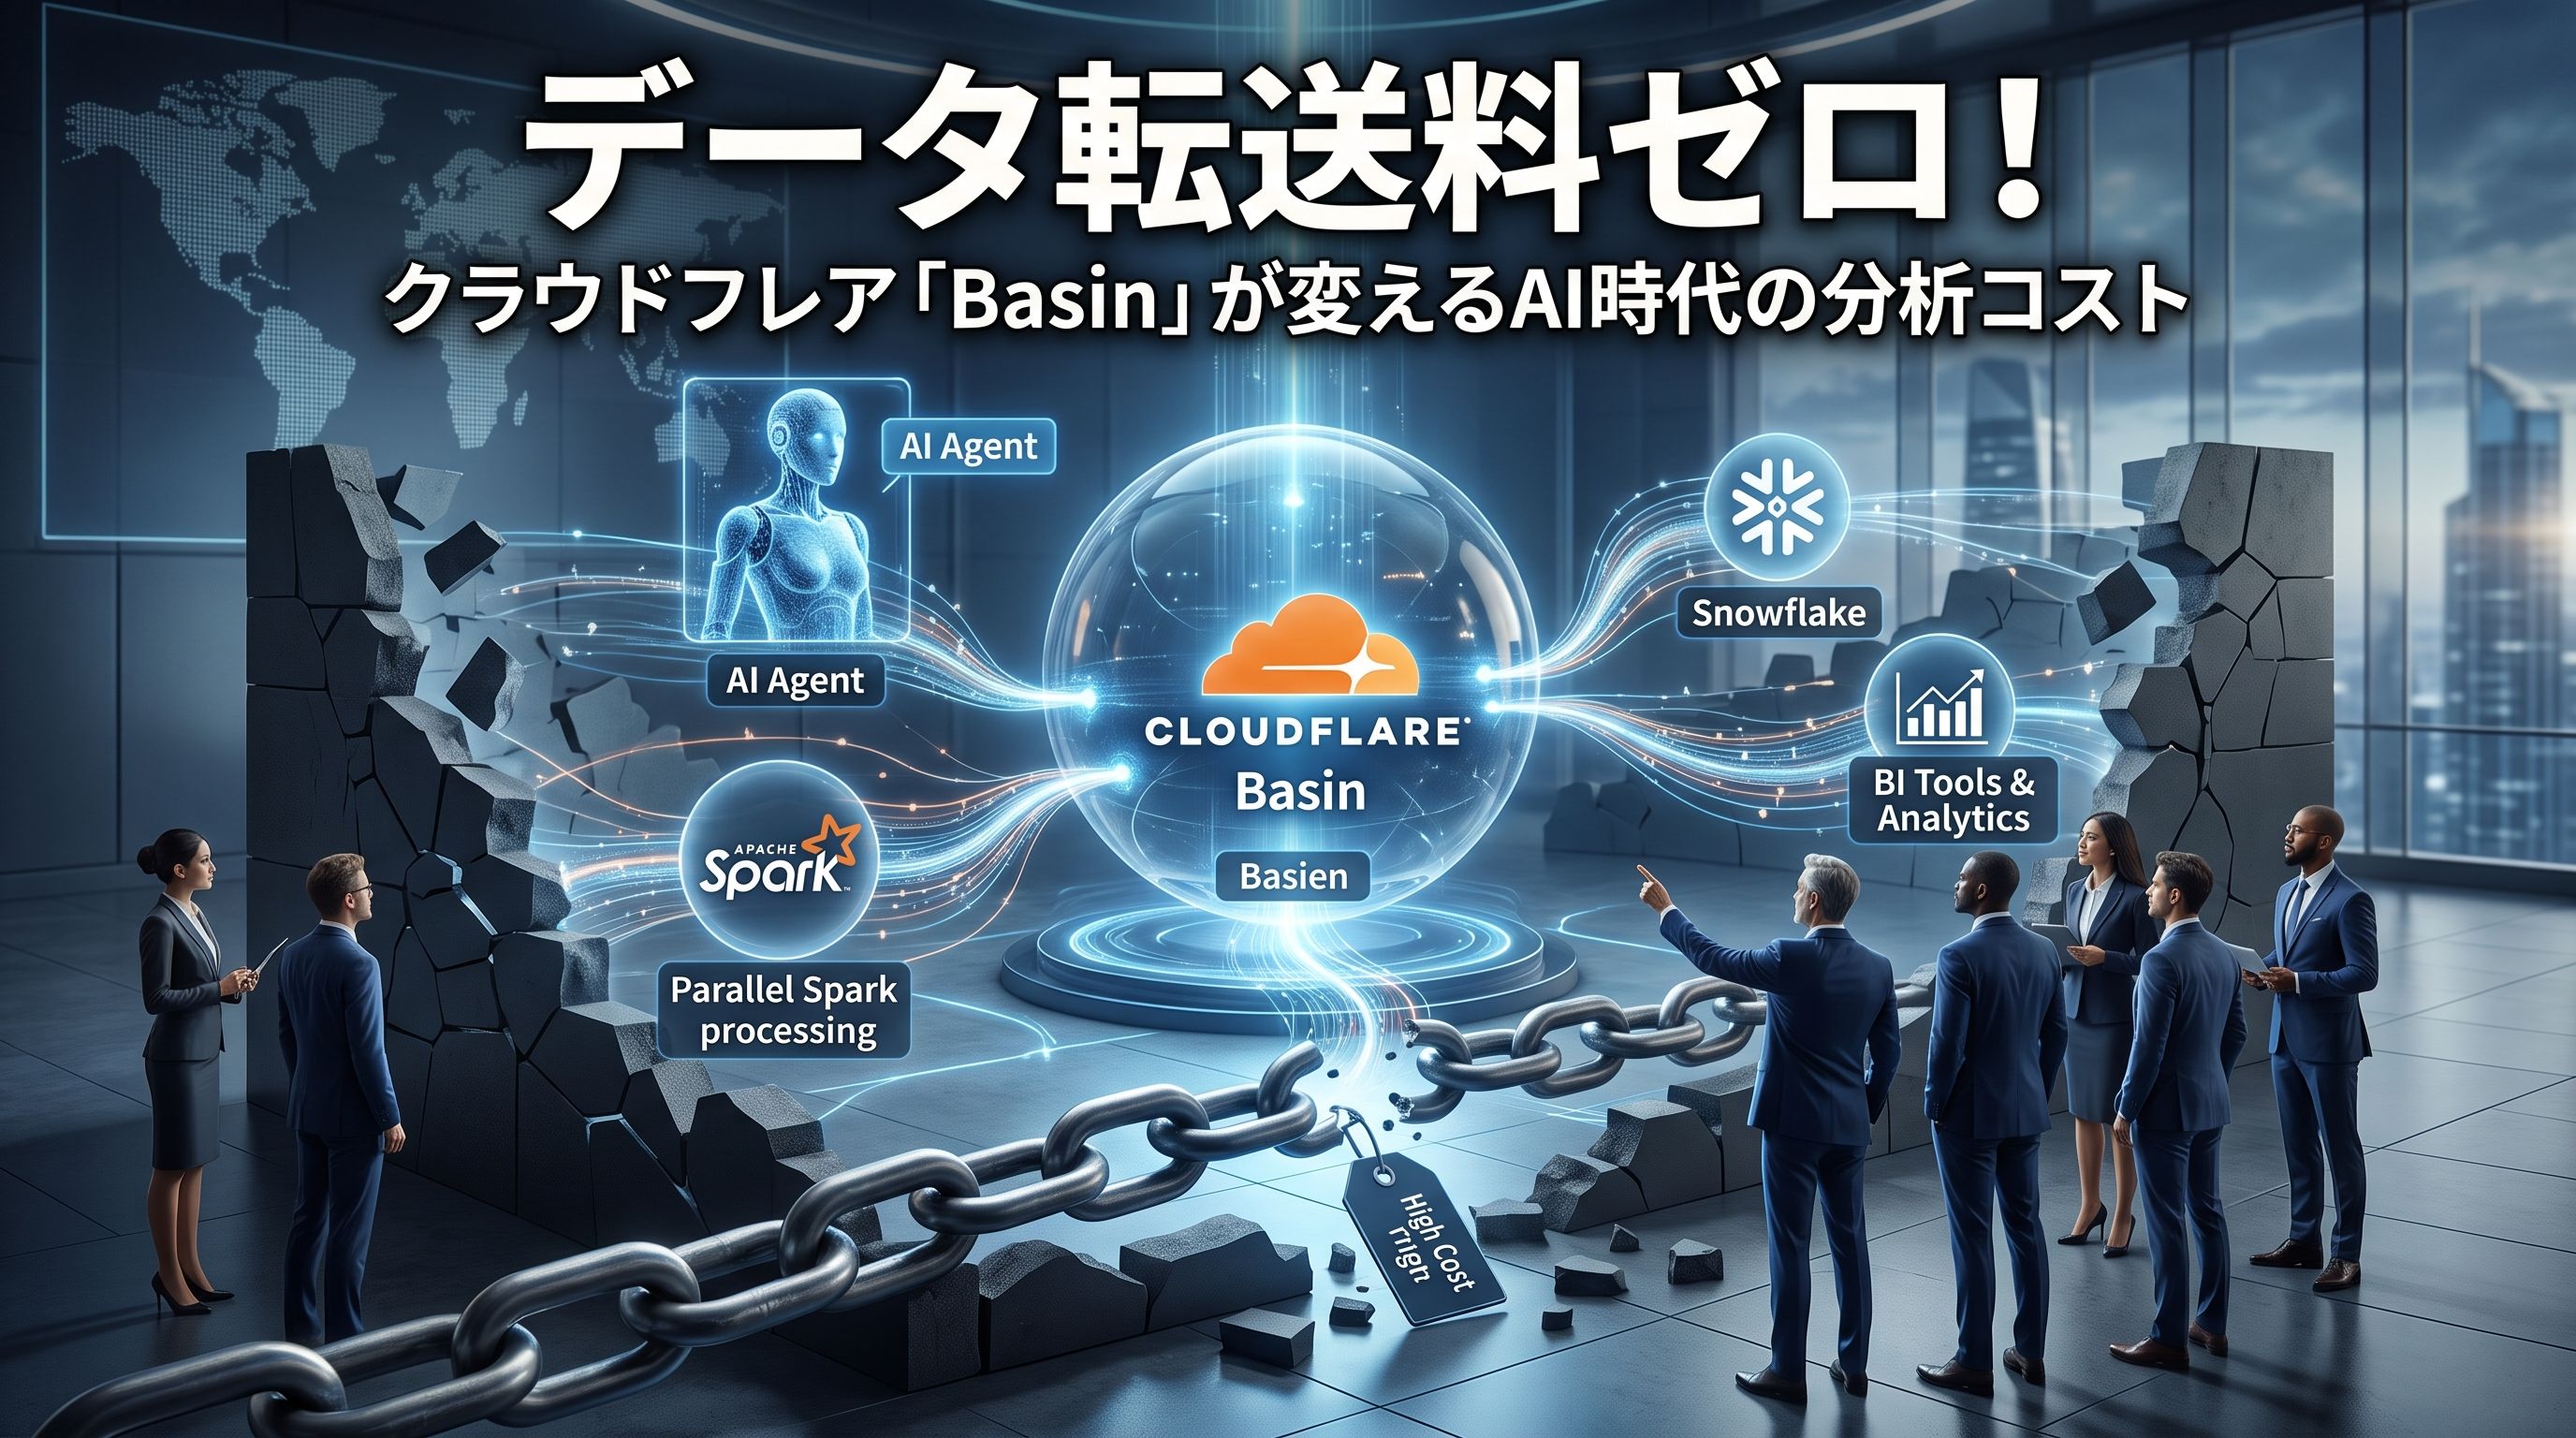
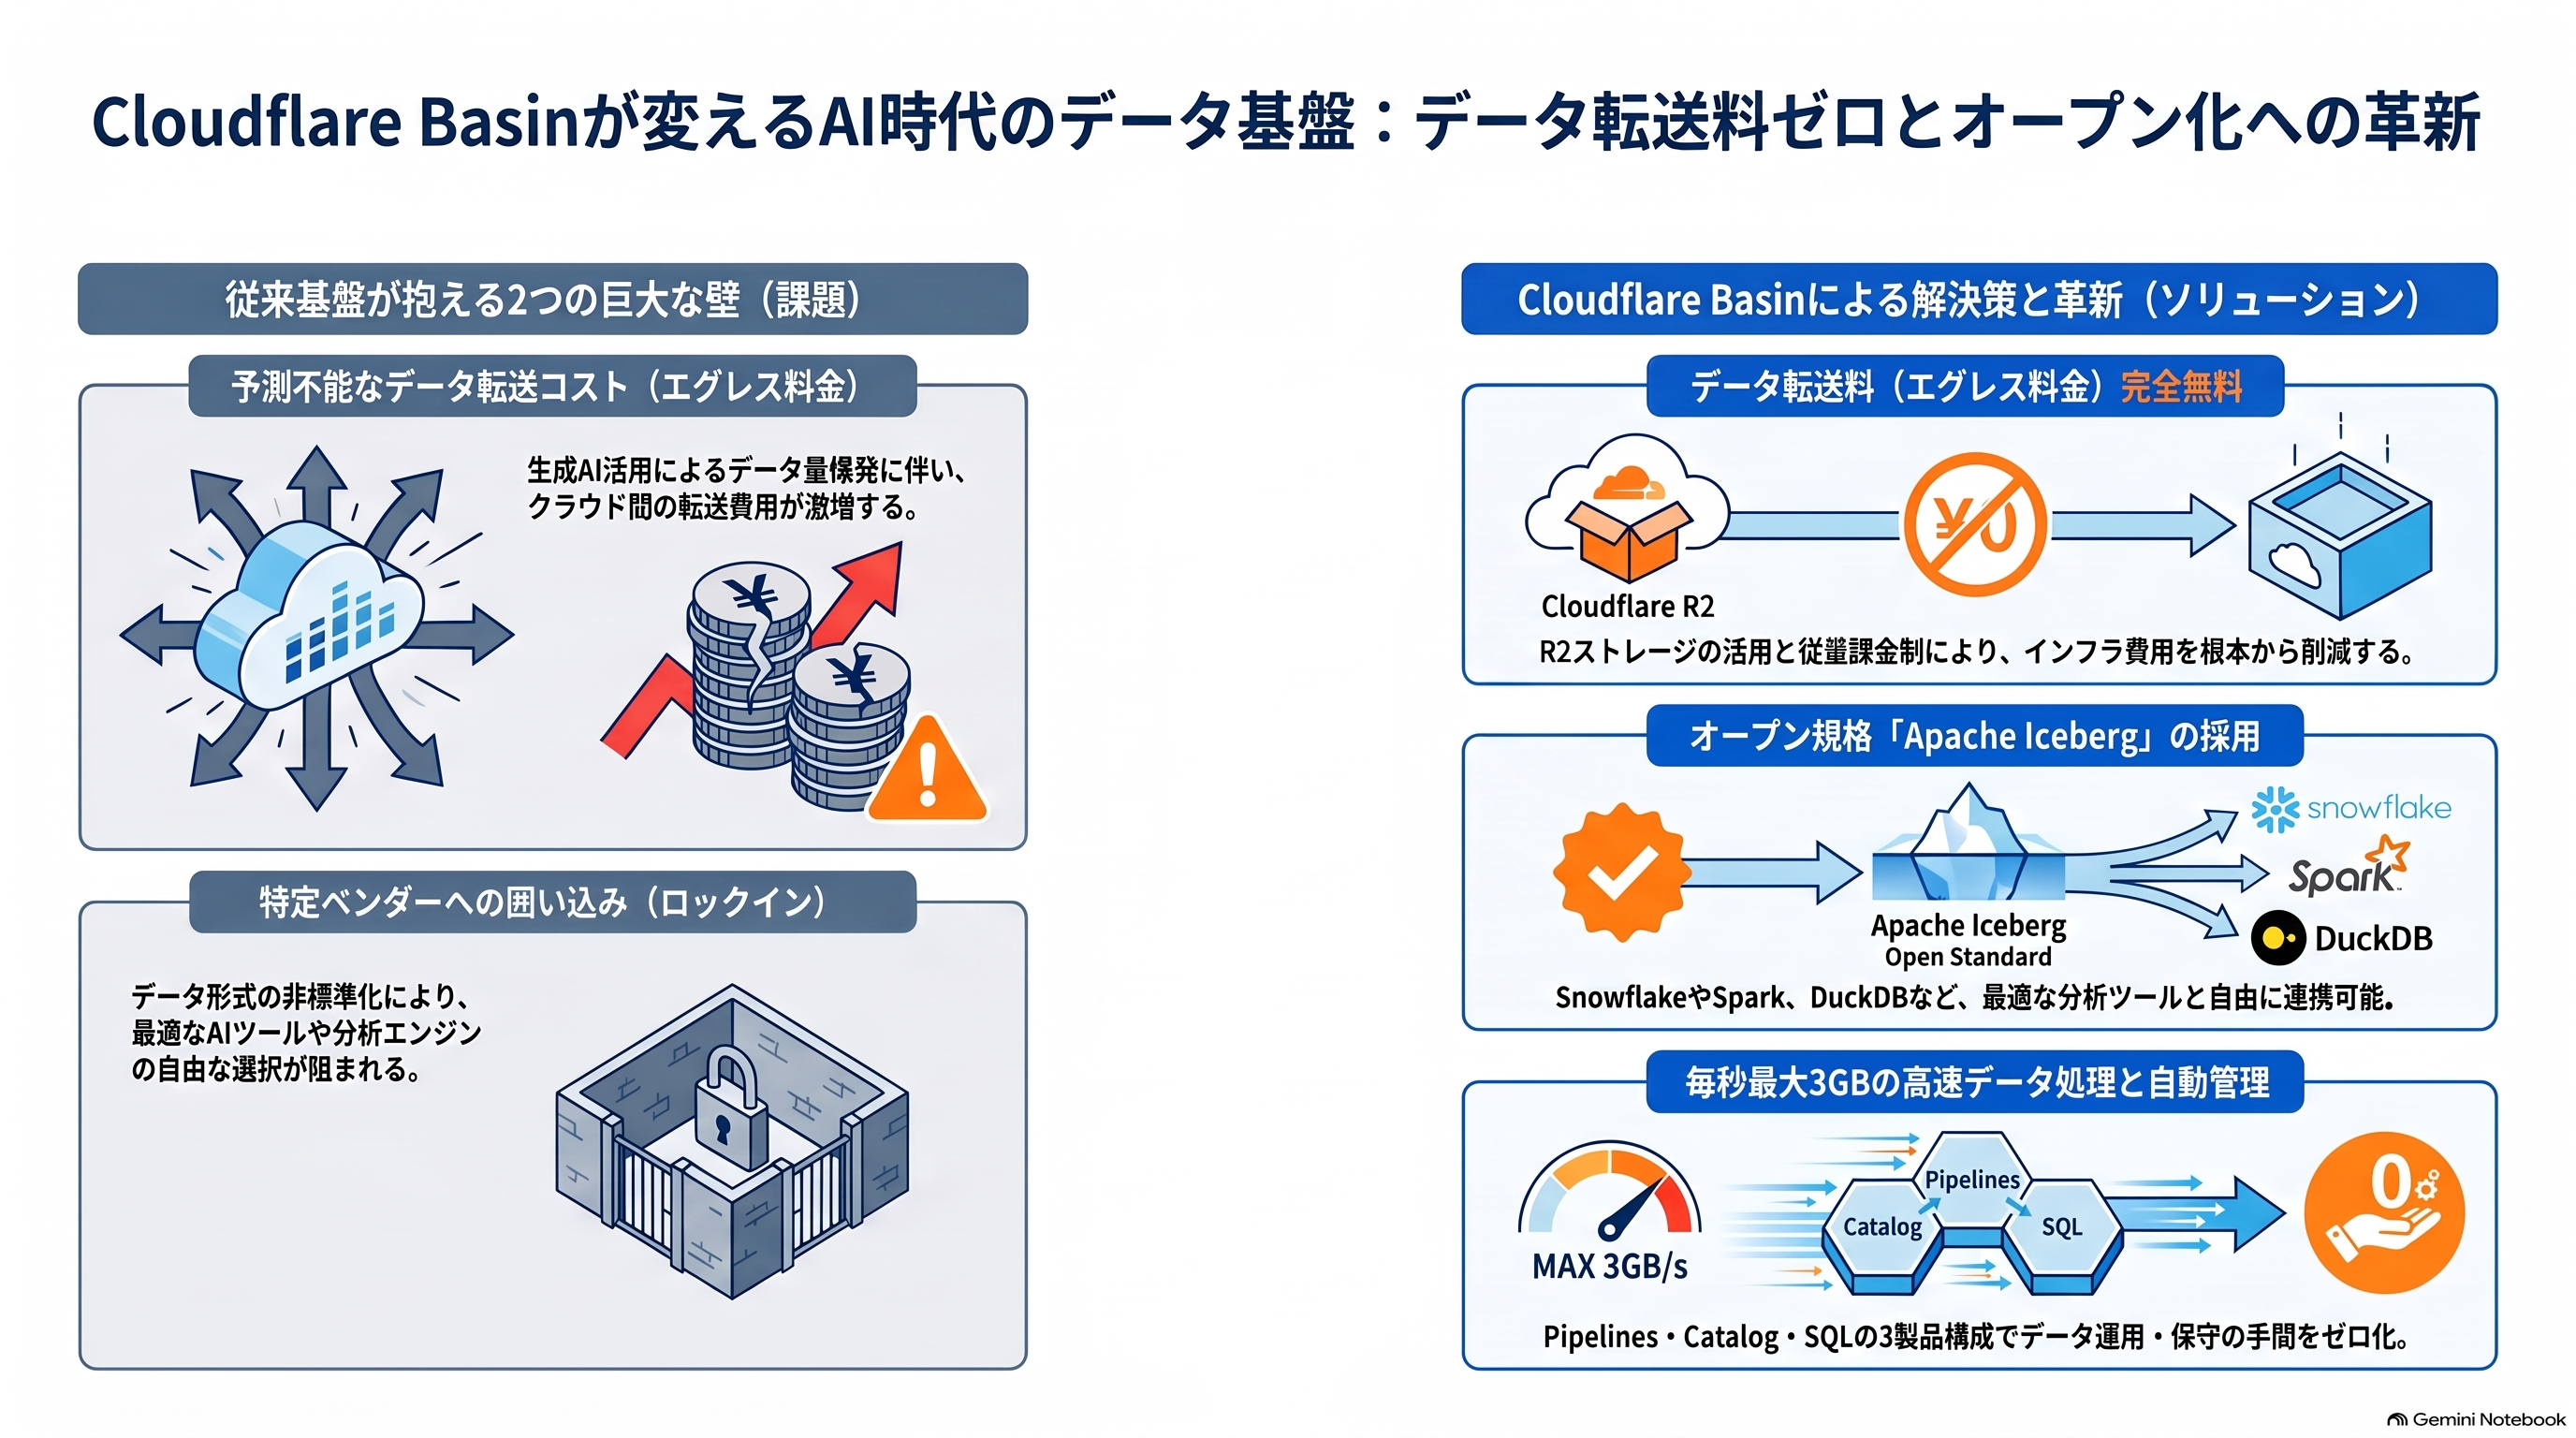
米Cloudflareは2026年10月1日、データ分析基盤「Cloudflare Basin」の一般提供を開始しました。2025年に「Cloudflare Data Platform」として発表し、ベータ版で提供してきたサービスを、正式版への移行に合わせて改称したものです。土台には、データレイク向けの公開規格「Apache Iceberg」と、同社のストレージ「R2」を使っています。
主な内容
「Basin Pipelines」がデータを受け取り、SQLで整えてから保存します。
「Basin Catalog」がテーブルの情報を管理し、ファイルの統合などの保守を自動で行います。
「Basin SQL」で、保存したテーブルをそのままSQLで検索できます。
DuckDBやSnowflake、Apache SparkなどIceberg対応のツールからも読み書きでき、転送料はかかりません。
料金は使った分だけの従量課金で、時間単位の課金はありません。
報告されている成果
Basin Pipelinesの取り込み性能:1ストリームあたり最大毎秒3GB
Basin SQLの関数:190超(結合やウィンドウ関数にも対応)
利用実績:ベータ期間中に数万件のPipelinesが作られ、Basin Catalogは数千人の開発者が利用
運営からのコメント
なぜ今、このニュースが重要なのか
社内でAIエージェントを動かそうとすると、最初に壁になるのはモデルよりもデータです。ログや業務データがクラウドごと、部署ごとに散らばり、取り出すたびに転送料や変換の手間がかかります。Basinは、データを公開規格のIceberg形式で1か所にため、好きなツールから転送料なしで読めるようにしました。Cloudflareも、指示文からデータアプリを作るコーディングエージェントの増加を開発の理由に挙げています。AI活用の前提となるデータの置き場所を、見直すきっかけになる発表です。
最大のポイント
見落とされやすいのは、「保管場所」と「分析ツール」を切り離した点です。従来は、あるクラウドにデータを置くと、そのクラウドの分析サービスを使うのが自然な流れでした。Iceberg形式で保存しておけば、同じデータをSnowflakeでもDuckDBでも、AIエージェントからでも扱えます。先行ユーザーの米Anomalyは、AWSのS3とAthenaを組み合わせた構成からBasinへ全社のデータパイプラインを移しました。ツールを乗り換えてもデータを移さずに済むことが、長期的なコストの差になります。
企業がいま取り組むべきこと
今週は、AIに分析させたいデータが社内のどこに、どの形式で置かれているかを書き出すことから始めてみてください。売上、問い合わせ履歴、システムのログなど、候補を5つほど挙げ、保管先のクラウド、ファイル形式、別のツールから使うときに費用がかかるかを表にまとめます。この表があれば、Basinのような基盤を試すべきか、既存のクラウド内で整えるべきかを判断できます。まずは使用量の少ないログを1種類選び、無料に近い規模で試すのが安全です。
出典
一次情報:Introducing Cloudflare Basin: an open, serverless data platform, now generally available(Cloudflare)
小松怜
Advanced AI Partnersのコンサルタント。生成AIニュースの執筆を担当し、国内外の生成AIの最新動向を企業の実務目線で解説しています。